LLM を 85% 圧縮しました。 llama.cpp の 2-bit と同じサイズで、はるかに賢い。
Pingala-8 は Qwen3-4B を 8.05 GB ではなく 1.24 GB で保存します。これは llama.cpp でよく使われる最小の 2-bit 形式 IQ2_XXS と同じファイルサイズで、しかも 5 つの標準的なクイズでスコアが 21% 高くなります。再学習は不要で、手元にあるモデルをそのまま圧縮します。コード、ログ、Windows 向けワンクリック版はすべて公開しています。
実時間で再生しており、早送りはしていません。テキストとタイミングは、RTX 5070 Ti Laptop GPU で Pingala-8 Qwen3-4B(1.24 GB)を実際に動かしたときのものです。チャット画面は再現したものです。
より小さく、同じサイズならより賢く、文章の生成は速い
特に断りのない限り Qwen3-4B の結果です。1 台の GPU(RTX 5070 Ti Laptop)で測定しました。すべての数値は論文とリポジトリ内のログにあります。
Qwen3-4B は 8.05 GB(fp16)から 1.24 GB へ、6.5 分の 1 になります。Llama-3.1-8B は 16.08 GB から 2.39 GB へ。
5 つのタスクの平均:50.8、IQ2_XXS は 41.9。8-bit モデルの 56.3 の 90% を保っています。
返答を生成するときは毎秒約 216 トークン(batch 1)で、IQ2_XXS の 1.10x。長いプロンプトの読み込みは遅く、0.74x です。
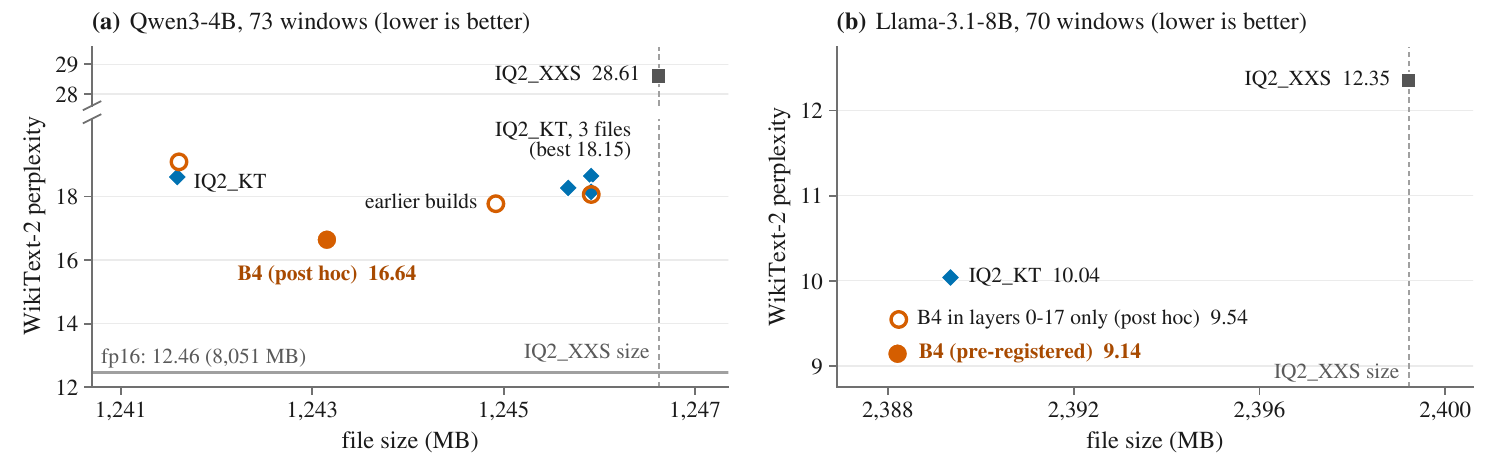
同じバイト数で、より低いパープレキシティ
パープレキシティは、モデルが実際の文章をどれだけうまく予測できるかを測る指標で、低いほど良い値です。WikiText-2 では、元の Qwen3-4B は 12.46 です。IQ2_XXS と同じファイルサイズで、Pingala-8 は 16.64 です。これに対し IQ2_XXS は 28.61(Pingala-8 の方が 42% 低い)、私たちが作ったこのサイズで最も強い IQ2_KT ファイルは 18.15 でした。
クイズのスコア(Qwen3-4B)
ゼロショットの正解率(%)。3 つの 2-bit ファイルはどれも約 1.24 GB です。元のモデルは 8-bit の Q8_0 ファイルです。
| タスク | 元のモデル(8-bit) | IQ2_XXS | IQ2_KT | Pingala-8 | IQ2_XXS 比 |
|---|---|---|---|---|---|
| ARC-Easy | 66.1 | 43.9 | 53.3 | 60.9 | +39% |
| ARC-Challenge | 45.2 | 29.1 | 35.1 | 37.8 | +30% |
| HellaSwag | 65.8 | 47.8 | 53.3 | 57.7 | +21% |
| WinoGrande | 65.5 | 57.5 | 57.9 | 63.8 | +11% |
| MMLU | 38.7 | 31.1 | 32.9 | 34.0 | +9% |
| 平均 | 56.3 | 41.9 | 46.5 | 50.8 | +21% |
Pingala-8 が勝つところ、ほかが勝つところ
Qwen3-4B、コンテキスト長 4096 での WikiText-2 パープレキシティ。すべてのファイルで同じテストです。低いほど良い値です。
| 形式 | サイズ | パープレキシティ | 正直なコメント |
|---|---|---|---|
| Pingala-8 (B4)Genrius AI | 1.24 GB | 16.64 | 元のモデルを圧縮するだけで、再学習は不要です。パッチを当てた llama.cpp と NVIDIA GPU(CUDA)が必要です。 |
| IQ2_XXSllama.cpp | 1.25 GB | 28.61 | 同じサイズ。公式版の llama.cpp、Ollama、LM Studio で動き、CPU や Mac でも使えます。プロンプトの読み込みはこちらが速い(私たちは 0.74x)。クイズのスコアは私たちが 21% 高く、生成速度は 1.10x です。 |
| IQ2_KTik_llama.cpp | 1.25 GB | 18.15 | 同じサイズで、私たちが作った同サイズの対抗馬の中で最も強いものです。プロンプトの読み込みは私たちより約 1.3x 速い。Qwen3-14B では私たちに勝ちます(9.40、私たちは 9.57)。 |
| Q4_K_Mllama.cpp | 私たちの約 2 倍 | 比較せず | より大きな 4-bit ファイルです。メモリが制約でないならこちらを選んでください。比較したのは速度だけで、batch 1 では半分のサイズで 39% 速く生成します。 |
| GSQ Q2_KISTA-DASLab | 1.67 GB | 14.37 | パープレキシティは私たちより良いですが、ファイルは 34% 大きくなります。 |
| Ternary Bonsai 4Bprism-ml | 1.07 GB | 11.59 | より良く、より小さい。Qwen3-4B を圧縮したものではなく再学習したモデルで(元のモデルにさえ勝ちます)、学習の実行と彼らのフォークが必要です。 |
| Qwen3-4B fp16元のモデル | 8.05 GB | 12.46 | 圧縮していないモデル。参考用です。 |
私たちの見方:テストした形式の中では、再学習せずに元の Qwen3-4B を約 1.24 GB に圧縮する場合、Pingala-8 のパープレキシティが最も低くなりました。このクラスの強い小型モデルが欲しいだけなら、Ternary Bonsai のような再学習済みのモデルの方が良い選択です。Pingala-8 は、誰も再学習してくれないモデルを圧縮するためのものです。Llama-3.1-8B(2.39 GB)でも、同じサイズの 2 つの形式の両方に勝っています:8.44、IQ2_KT は 9.36。
3 ステップで試す
Windows または Linux と、NVIDIA RTX GPU(30、40、50 シリーズ)、新しいドライバーが必要です。Python もビルドも不要です。
注意:公式版の llama.cpp、Ollama、LM Studio では、このファイルはまだ読み込めません。ワンクリック版に入っているパッチ済みの llama.cpp を使ってください。
-
ダウンロード
v2.4-oneclick リリースから
pingala8-windows-cuda12.zip(1.6 GB)を入手します。Linux:同じページにある
pingala8-linux-cuda13.tar.gz。 -
解凍してダブルクリック
run_qwen3_4b.bat(またはrun_llama31_8b.bat)を実行します。モデルは初回に一度だけ Hugging Face からダウンロードされます。Linux:
./run.sh qwenまたは./run.sh llama。 -
チャット
Windows では、ブラウザで
http://127.0.0.1:8080のチャットページが開きます(Linux ではこのアドレスを自分で開いてください)。すべてあなたのマシンの上で動きます。黒いウィンドウを閉じると停止します。
ソースからのビルド、論文のパープレキシティテストの実行、CPU パッチの利用については、README のクイックスタート(英語)を見てください。モデル:Qwen3-4B と Llama-3.1-8B。
4 つの重みのグループにかけるトレリス符号
多くの 2-bit 形式は、重みの小さなグループをそれぞれ独立に丸めます。Pingala-8 は Ungerboeck の 8 状態トレリス符号で、グループを順番に符号化します。小さな状態が 4 つの重みのグループから次のグループへ引き継がれ、次のグループが使える値の集合を決めるので、同じビット数でも本来の重みにより近づきます。
符号化の前に、ランダムな Hadamard 回転でごく少数の非常に大きな重みを分散させ、LDLQ 丸めで各列の誤差をまだ符号化していない列へ渡します。これらのアイデアは QuIP、QuIP#、QTIP から来ており、この形式は ikawrakow の IQ2_KT に近いものです。llama.cpp への CUDA パッチ(commit 7ac59a6)がこのファイルを読み込みます。
やさしい解説と技術的な詳しい話は、記事の全文(英語)をどうぞ。
名前の由来
Pingala の Chandahsutra は、詩の韻律を扱った古代サンスクリットの書物で、長音節または短音節 3 つからなる 8 つのパターン、gana を挙げています。私たちの符号も短いパターンの上に 8 つの状態を持つので、彼の名前をいただきました。名前は敬意を表したもので、トレリスのラベルは Ungerboeck によるものです。
失うもの
Pingala-8 を選ぶ前に、ここを読んでください。
- Qwen3-14B では負けます。実行前に勝つと予測しましたが、勝てませんでした。WikiText-2 で 9.57、IQ2_KT は 9.40。C4 では引き分けです。
- プロンプトの処理が遅い。プロンプトの読み込みは IQ2_XXS の 0.74x です。長い文書では、最初の単語が出るまでに時間がかかります。
- バッチでのデコードが遅い。2 件から 8 件のチャットを同時に処理すると、IQ2_XXS の 0.18x から 0.34x になります。1 台の GPU を 1 人で使う用途向けで、サーバー向けではありません。
- 専用のランタイムが必要。CUDA 対応のパッチ済み llama.cpp だけで動きます。公式版の llama.cpp、Ollama、LM Studio はまだ読み込めません。Metal と Vulkan には対応していません。CPU での生成は IQ2_XXS の 0.56x から 0.62x です。
- Qwen3-4B の数値は調整済みです。このファイルは、WikiText-2 でテストした多数のビルドの最後のものです。C4 はテスト用に取っておきました。Llama-3.1-8B と Qwen3-14B の実行は事前登録しています。
- GPU は 1 台だけ、安全性の評価はなし。速度は RTX 5070 Ti Laptop GPU 1 台で測定しました。圧縮したモデルの安全面の振る舞いは評価していません。
さらに読む(英語)
以下のページは、今のところ英語版だけです。
- 記事:再学習なしで Qwen3-4B を 1.24 GB に収めた方法何を作ったのか、なぜ 2-bit が重要なのか、測定した数値とその範囲、失うもの、そして試し方。
- 小さな GPU で LLM を動かすためのガイドメモリ、量子化、品質についてのやさしいガイド。測定した数値と、Pingala-8 が向く場面、向かない場面を載せています。
- 論文:要旨、PDF、BibTeXプレプリント、バージョン 2.4。DOI 10.5281/zenodo.23481757。
- 再現手順(REPRODUCE.md)論文の数値を再現する方法。
論文を読む、引用する
Small-State Coset Trellis Coding at IQ2_XXS Size: An Equal-Bytes Study in llama.cpp
Harshit Goyal、Genrius AI。プレプリント、バージョン 2.4、2026 年 10 月。DOI:10.5281/zenodo.23481757
@misc{goyal2026pingala8,
  title     = {Small-State Coset Trellis Coding at {IQ2\_XXS} Size:
               An Equal-Bytes Study in {llama.cpp}},
  author    = {Goyal, Harshit},
  year      = {2026},
  month     = oct,
  publisher = {Zenodo},
  doi       = {10.5281/zenodo.23481757},
  url       = {https://doi.org/10.5281/zenodo.23481757},
  note      = {Preprint, version 2.4.
               Code: https://github.com/Genrius-AI/pingala8-llm}
}