我们把大模型压缩了 85%。 与 llama.cpp 的 2-bit 一样大,却聪明得多。
Pingala-8 把 Qwen3-4B 存成 1.24 GB,而原始模型是 8.05 GB。这与 llama.cpp 最小的常用 2-bit 格式 IQ2_XXS 的文件大小相同,而它在五项标准测验上的得分高出 21%。无需重新训练:它直接压缩你手上已有的模型。代码、日志和 Windows 一键包全部公开。
实时播放,未加速。文字和时间来自 Pingala-8 Qwen3-4B(1.24 GB)在 RTX 5070 Ti Laptop GPU 上的一次真实运行;聊天窗口是重新制作的。
更小,同等大小下更聪明,生成速度快
除特别注明外,均为 Qwen3-4B。在一块 GPU(RTX 5070 Ti Laptop)上测得。每个数字都能在论文和仓库里的日志中找到。
Qwen3-4B 从 8.05 GB(fp16)降到 1.24 GB,只有原来的 1/6.5。Llama-3.1-8B 从 16.08 GB 降到 2.39 GB。
五项任务的平均分:50.8,IQ2_XXS 为 41.9。保留了 8-bit 模型 56.3 分的 90%。
生成回复时约每秒 216 个 token(batch 1),是 IQ2_XXS 的 1.10x。读取长提示词较慢:0.74x。
同样的字节数,更低的困惑度
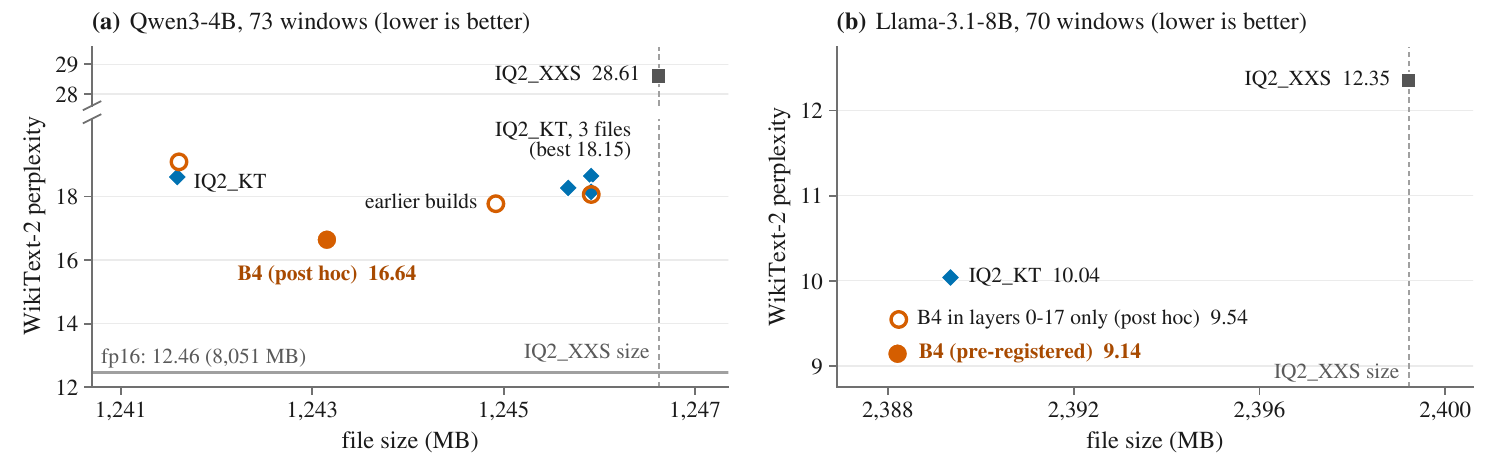
困惑度(perplexity)衡量模型预测真实文本的能力,越低越好。在 WikiText-2 上,原始 Qwen3-4B 为 12.46。在 IQ2_XXS 的文件大小下,Pingala-8 为 16.64;相比之下,IQ2_XXS 为 28.61(Pingala-8 低 42%),我们构建的同等大小中最强的 IQ2_KT 文件为 18.15。
测验得分,Qwen3-4B
零样本准确率(%)。三个 2-bit 文件都约为 1.24 GB。原始模型指 8-bit 的 Q8_0 文件。
| 任务 | 原始(8-bit) | IQ2_XXS | IQ2_KT | Pingala-8 | 相对 IQ2_XXS |
|---|---|---|---|---|---|
| ARC-Easy | 66.1 | 43.9 | 53.3 | 60.9 | +39% |
| ARC-Challenge | 45.2 | 29.1 | 35.1 | 37.8 | +30% |
| HellaSwag | 65.8 | 47.8 | 53.3 | 57.7 | +21% |
| WinoGrande | 65.5 | 57.5 | 57.9 | 63.8 | +11% |
| MMLU | 38.7 | 31.1 | 32.9 | 34.0 | +9% |
| 平均 | 56.3 | 41.9 | 46.5 | 50.8 | +21% |
Pingala-8 胜在哪里,其他格式又胜在哪里
Qwen3-4B,上下文长度 4096 下的 WikiText-2 困惑度,每个文件都用同一项测试。越低越好。
| 格式 | 大小 | 困惑度 | 我们的坦诚说明 |
|---|---|---|---|
| Pingala-8 (B4)Genrius AI | 1.24 GB | 16.64 | 直接压缩原始模型,无需重新训练。需要我们修改过的 llama.cpp 和 NVIDIA GPU(CUDA)。 |
| IQ2_XXSllama.cpp | 1.25 GB | 28.61 | 大小相同。可以在原版 llama.cpp、Ollama 和 LM Studio 中运行,也支持 CPU 和 Mac。读取提示词更快(我们只有它的 0.74x)。我们的测验得分高 21%,生成速度是它的 1.10x。 |
| IQ2_KTik_llama.cpp | 1.25 GB | 18.15 | 大小相同,也是我们构建的同等大小对手中最强的。读取提示词比我们快约 1.3x。在 Qwen3-14B 上它胜过我们(9.40,我们为 9.57)。 |
| Q4_K_Mllama.cpp | 约为我们的 2 倍 | 未比较 | 更大的 4-bit 文件;如果内存不是你的瓶颈,就选它。我们只比较了速度:在 batch 1 下,我们以一半的大小,生成速度快 39%。 |
| GSQ Q2_KISTA-DASLab | 1.67 GB | 14.37 | 困惑度比我们好,但文件大 34%。 |
| Ternary Bonsai 4Bprism-ml | 1.07 GB | 11.59 | 更好,也更小。它是重新训练的模型,而不是对 Qwen3-4B 的压缩(它甚至胜过原始模型),需要一次训练以及他们的分支(fork)。 |
| Qwen3-4B fp16原始模型 | 8.05 GB | 12.46 | 未压缩的模型,供参考。 |
我们的解读:在我们测试过的格式中,如果不重新训练、把原始 Qwen3-4B 压缩到约 1.24 GB,Pingala-8 的困惑度最低。如果你只是想要这一级别里一个强的小模型,像 Ternary Bonsai 这样重新训练过的模型是更好的选择。Pingala-8 适合压缩那些没有人替你重新训练过的模型。在 Llama-3.1-8B(2.39 GB)上,它同样胜过两种同等大小的格式:8.44,IQ2_KT 为 9.36。
3 步试用
需要 Windows 或 Linux,一块 NVIDIA RTX GPU(30、40 或 50 系列)和较新的驱动程序。无需 Python,无需编译。
注意:原版 llama.cpp、Ollama 和 LM Studio 目前无法加载这些文件,请使用一键包里修改过的 llama.cpp。
-
下载
从 v2.4-oneclick 发布页 下载
pingala8-windows-cuda12.zip(1.6 GB)。Linux:同一页面上的
pingala8-linux-cuda13.tar.gz。 -
解压并双击
运行
run_qwen3_4b.bat(或run_llama31_8b.bat)。模型会从 Hugging Face 下载一次。Linux:
./run.sh qwen或./run.sh llama。 -
聊天
在 Windows 上,浏览器会打开聊天页面
http://127.0.0.1:8080(在 Linux 上请自己打开这个地址)。一切都在你的电脑上运行。关闭黑色窗口即可停止。
从源码构建、运行论文中的困惑度测试,或使用 CPU 补丁:请参阅 README 中的快速入门(英文)。模型:Qwen3-4B 和 Llama-3.1-8B。
作用于每组 4 个权重的网格码(trellis code)
大多数 2-bit 格式对每一小组权重单独取整。Pingala-8 用 Ungerboeck 的 8 状态网格码按顺序对各组编码:一个很小的状态从一组 4 个权重传到下一组,并决定下一组可以使用哪一组取值,所以同样的比特能更接近真实的权重。
编码之前,随机 Hadamard 旋转会把少数特别大的权重分散开,LDLQ 取整则把每一列的误差传给尚未编码的列。这些思路来自 QuIP、QuIP# 和 QTIP,这种格式与 ikawrakow 的 IQ2_KT 相近。llama.cpp 的一个 CUDA 补丁(commit 7ac59a6)负责读取这个文件。
阅读完整文章(英文),了解通俗的解释和技术细节。
名字的由来
Pingala 的 Chandahsutra 是一部论述诗歌格律的古代梵语著作,书中列出了由三个长音节或短音节组成的 8 种模式,即 gana。我们的编码在短模式上有 8 个状态,所以用他的名字命名。这个名字是一种致敬;网格的标签来自 Ungerboeck。
我们的不足
选择 Pingala-8 之前,请先读完这一部分。
- 在 Qwen3-14B 上落败。我们在运行前预测会胜出,结果没有:在 WikiText-2 上为 9.57,IQ2_KT 为 9.40;在 C4 上打平。
- 提示词处理更慢。读取提示词的速度是 IQ2_XXS 的 0.74x。长文档在输出第一个字之前要等更久。
- 批量解码更慢。同时服务 2 到 8 个对话时,速度是 IQ2_XXS 的 0.18x 到 0.34x。它适合一个人用一块 GPU,不适合做服务器。
- 需要我们的运行时。仅支持带 CUDA 的修改版 llama.cpp。原版 llama.cpp、Ollama 和 LM Studio 目前还无法加载。不支持 Metal 或 Vulkan;CPU 生成速度是 IQ2_XXS 的 0.56x 到 0.62x。
- Qwen3-4B 的数字经过调优。这个文件是在 WikiText-2 上测试过的众多构建中的最后一个。C4 是留出的测试集;Llama-3.1-8B 和 Qwen3-14B 的运行都是预先登记的。
- 只测了一块 GPU,没有安全评估。速度是在一块 RTX 5070 Ti Laptop GPU 上测得的。我们没有评估压缩后模型的安全行为。
更多资料(英文)
以下页面目前只有英文版。
- 文章:我们如何在不重新训练的情况下把 Qwen3-4B 装进 1.24 GB我们做了什么、为什么 2-bit 很重要、实测数字及其适用范围、我们的不足,以及如何试用。
- 在小显存 GPU 上运行大模型的指南关于显存、量化和质量的通俗指南,附实测数字,并说明 Pingala-8 适合和不适合的场景。
- 论文:摘要、PDF 和 BibTeX预印本第 2.4 版,DOI 10.5281/zenodo.23481757。
- 复现方法(REPRODUCE.md)如何复现论文中的数字。
阅读并引用论文
Small-State Coset Trellis Coding at IQ2_XXS Size: An Equal-Bytes Study in llama.cpp
Harshit Goyal,Genrius AI。预印本,第 2.4 版,2026 年 10 月。DOI:10.5281/zenodo.23481757
@misc{goyal2026pingala8,
  title     = {Small-State Coset Trellis Coding at {IQ2\_XXS} Size:
               An Equal-Bytes Study in {llama.cpp}},
  author    = {Goyal, Harshit},
  year      = {2026},
  month     = oct,
  publisher = {Zenodo},
  doi       = {10.5281/zenodo.23481757},
  url       = {https://doi.org/10.5281/zenodo.23481757},
  note      = {Preprint, version 2.4.
               Code: https://github.com/Genrius-AI/pingala8-llm}
}